Analisi quantitativa con pochi dati
di Vincenzo Calabrò · Pubblicato il
Abstract
Il white paper esamina in che misura le tecniche di intelligenza artificiale riunite sotto l’etichetta di AI-driven Cyber Risk Management possano supplire alla scarsità di dati che limita l’analisi quantitativa del rischio cyber. Individua le lacune del modello Open FAIR, descrive quattro modalità di intervento e ne valuta le evidenze, dai dati di FIRST sul modello EPSS ai benchmark sui large language model. Un esempio numerico mostra che cosa cambia quando una stima ricavata da un solo evento interno viene combinata con dati esterni; una verifica su dati pubblici di NVD, catalogo KEV, EPSS e VERIS mette poi alla prova i meccanismi e le ipotesi dell’esempio. Chiudono il documento i vincoli posti da NIS2, DORA e AI Act e i limiti che nessuna tecnica supera.
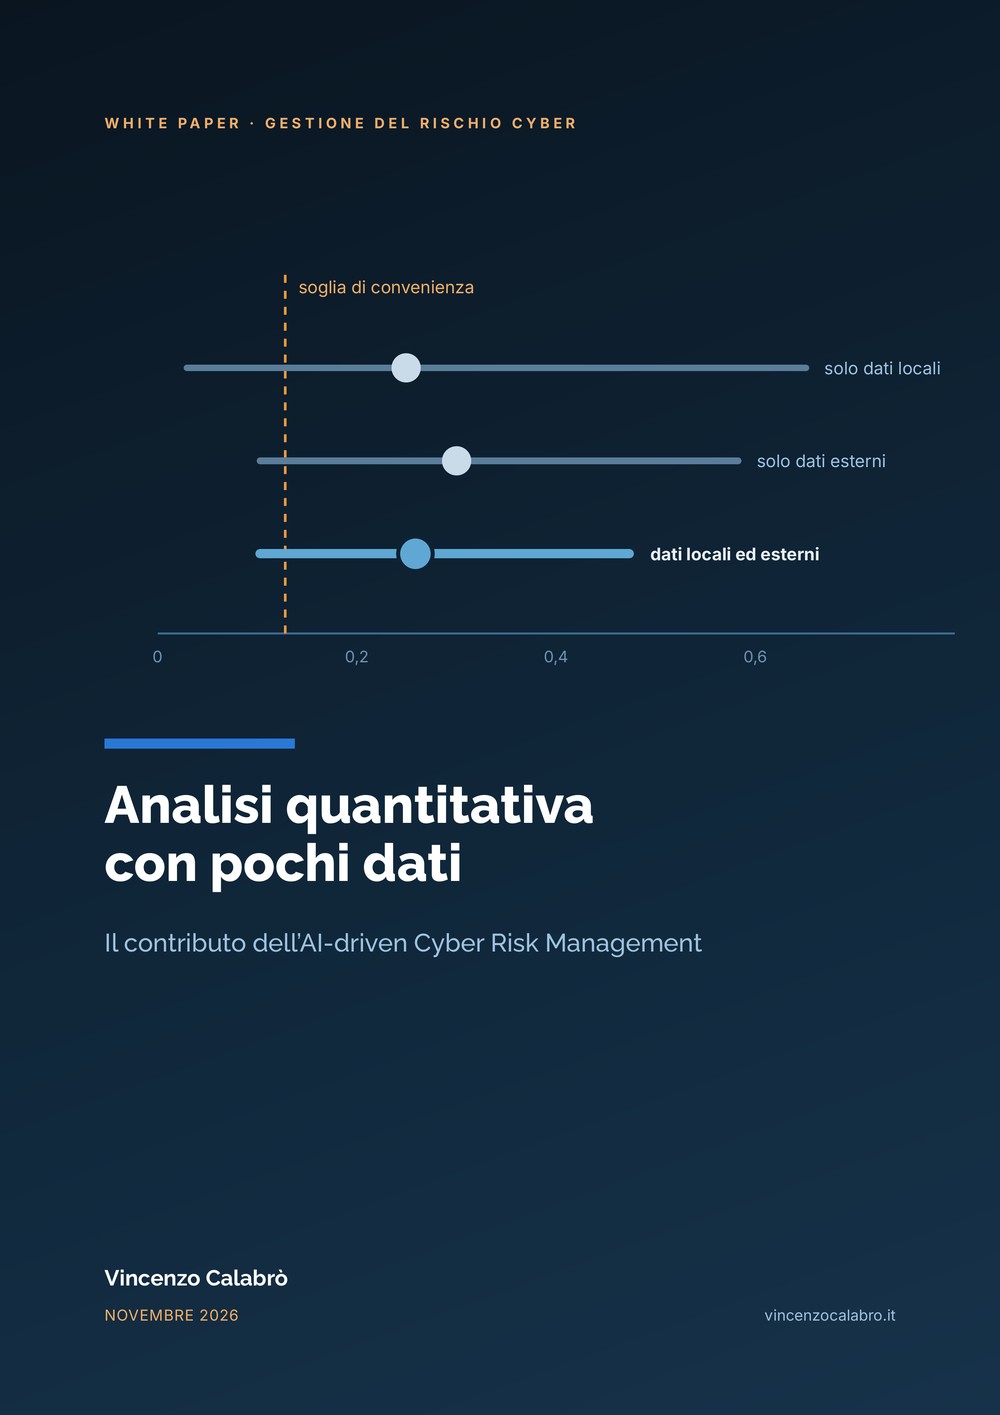 Il contributo dell’AI-driven Cyber Risk Management. Le stime di frequenza e di perdita su cui si regge l’analisi quantitativa richiedono dati che una singola organizzazione possiede di rado: gli eventi osservati sono pochi, molti incidenti non vengono resi pubblici e le basi informative aperte sono incomplete. Una rassegna di norme, pubblicazioni di organismi tecnici, report di settore e letteratura peer-reviewed disponibili a novembre 2026, insieme a una verifica su dati reali e pubblici, mostra dove l’AI rende utilizzabile un’informazione che esiste altrove e dove il suo contributo si ferma, cioè quando il dato manca per ragioni legate al suo stesso valore.
Il problema dei dati
NIS2 e DORA non prescrivono un metodo di valutazione, ma le valutazioni che richiedono si prestano a essere espresse, come gli altri rischi d’impresa, in termini di frequenza attesa e di entità della perdita. I dati per produrre queste stime sono scarsi. Nel primo semestre 2026 il Clusit ha censito nel mondo 4.911 incidenti gravi di dominio pubblico, ma per 3.321 di essi la tecnica di attacco non si ricava dalle fonti pubbliche. Dal 15 aprile 2026 il NIST dà la precedenza, nell’attribuzione dei punteggi di severità e degli elenchi dei prodotti interessati, alle CVE di tre categorie prioritarie, mentre il CVE Program ha pubblicato 72.812 record nei primi nove mesi dell’anno. Al proprio interno, poi, ogni organizzazione osserva troppo pochi eventi di perdita per ricavarne una distribuzione.
Dove mancano i dati e perché
Lo standard Open FAIR scompone il rischio nella frequenza degli eventi di perdita e nella loro magnitudo, e per ciascun fattore richiede una stima espressa come distribuzione. Il documento individua quattro vuoti: la frequenza degli eventi, l’entità delle perdite, gli attributi delle vulnerabilità e l’efficacia dei controlli, il cui effetto atteso è quasi sempre un’ipotesi. Seguendo la teoria dei dati mancanti di Rubin, distingue poi il dato che manca per caratteristiche osservabili, come la CVE esclusa dalle categorie prioritarie, da quello che manca a causa del suo valore, come la perdita non dichiarata perché elevata o dannosa per la reputazione.
Quattro modalità di intervento
La prima è la stima di grandezze che nessuna organizzazione può osservare in sede. EPSS ricava da un modello di machine learning, addestrato sull’attività rilevata dai sensori di più partner, la probabilità di osservare tentativi di exploitation di ciascuna CVE nei trenta giorni successivi. La seconda completa i record parziali, ad esempio stimando il vettore CVSS dalla sola descrizione della vulnerabilità. La terza estrae dati strutturati da rapporti e bollettini, la quarta combina stime esterne, osservazioni locali e giudizio esperto con l’aggiornamento bayesiano. I dati sintetici servono ad addestrare e collaudare i modelli, ma non aggiungono informazione sulle perdite reali.
Le evidenze
Le prove più solide riguardano le prime due modalità. Nel confronto pubblicato da FIRST, rimediare tutte le CVE con CVSS pari o superiore a 7 significa intervenire su 80.024 vulnerabilità per intercettarne 3.166 sfruttate nel mese successivo; con una soglia EPSS del 10% le CVE da trattare scendono a 3.735 e quelle intercettate sono 2.435. Lo sforzo si riduce di oltre venti volte, la copertura di diciannove punti percentuali. Per il completamento dei record e l’estrazione dai testi esistono studi sperimentali e benchmark, che però misurano l’accuratezza dei modelli e non l’effetto sulla stima finale del rischio.
Un esempio numerico
Alfa, un’impresa ipotetica con circa 1.500 dipendenti, ha registrato in sei anni un solo data breach dovuto allo sfruttamento di una vulnerabilità. Con i soli dati locali l’intervallo di credibilità al 90% sulla frequenza annua va da 0,03 a 0,65 eventi; combinando l’osservazione con una stima esterna si restringe tra 0,10 e 0,47, con un’ampiezza inferiore del 40%. La perdita annua attesa resta quasi la stessa, mentre la probabilità che un programma di remediation e detection da 180.000 euro l’anno si ripaghi passa dal 67% a quasi il 90%. Nello stesso esempio l’ordinamento per EPSS chiude nel primo mese 175 delle 276 vulnerabilità per le quali è attesa attività di exploitation, contro circa 16 con il solo CVSS.
La verifica su dati pubblici
Per mettere alla prova le ipotesi dell’esempio, il documento misura le stesse grandezze su dati reali e pubblici: la National Vulnerability Database al 21 novembre 2026, il catalogo KEV di CISA, i punteggi EPSS del 2025 e il VERIS Community Database. Le lacune risultano ampie: la quota di CVE con punteggio di severità del NIST, superiore al 92% fino al 2023, scende al 14,5% per quelle del 2026, e soltanto il 3,2% degli incidenti della raccolta VERIS riporta l’importo della perdita. Un modello semplice che stima la severità dalla sola descrizione assegna la stessa classe del NIST nel 71,5% delle CVE del 2023; sulle vulnerabilità valutate anche dalla CNA concorda con il NIST più spesso della CNA stessa (70,4% contro 57,5%). Sulle CVE del 2026 l’accuratezza scende però al 54,8%.
Sul tasso di sfruttamento delle vulnerabilità dei vendor, con 50 osservazioni la combinazione con una stima esterna dimezza l’errore di stima. Se però la stima esterna sottovaluta il valore reale di almeno tre volte, gli intervalli al 90% costruiti su 25 osservazioni lo contengono soltanto nel 43% dei casi. Appresa dai dati, la stima esterna vale 0,23 eventi osservati anziché i quattro ipotizzati per Alfa: trasposto all’esempio, questo valore porterebbe dall’89,5% al 52,3% la probabilità che il programma si ripaghi. Nemmeno la frequenza resta costante nel tempo, e le severità degli incidenti, misurate dal numero di record compromessi, hanno una coda così pesante che la media non è stimabile in modo stabile. Rispetto all’inserimento nel catalogo KEV, infine, la soglia EPSS del 10% concentra la remediation circa sei volte meglio della soglia CVSS 7 con un decimo del lavoro, ma intercetta circa la metà degli inserimenti successivi.
Norme e limiti
Le norme europee non impongono né l’AI né un metodo quantitativo. La NIS2 chiede misure proporzionate a probabilità e gravità degli incidenti e procedure per valutarne l’efficacia, il regolamento DORA un framework documentato di ICT risk management. Per i sistemi ad alto rischio l’AI Act fissa requisiti di accuratezza, robustezza e cybersecurity, la cui applicazione il regolamento (UE) 2026/1744 ha rinviato al 2 dicembre 2027 per i sistemi dell’Allegato III e al 2 agosto 2028 per quelli dell’Allegato I.
Il limite principale riguarda il dato che può mancare a causa del suo valore. Un modello addestrato sui casi pubblici apprende la distribuzione dei casi pubblici: se le perdite taciute sono le più alte, le stime che ne derivano sono distorte verso il basso in una misura che i dati disponibili non permettono di calcolare. Nella verifica, quando la selezione dei casi dichiarati dipende da variabili osservate, l’imputazione riduce lo scarto a valori tra il 3% e il 34%; quando dipende dalla severità, il valore tipico resta sottostimato dal 61% al 96% anche dopo l’imputazione. Il documento segnala inoltre gli errori ricorrenti nella valutazione dei modelli di machine learning per la sicurezza, le riserve ancora aperte sull’affidabilità dei large language model e il rischio che un attaccante alteri le fonti esterne da cui dipendono le stime.
Le conclusioni
Secondo il documento le tecniche di AI incidono sulla scarsità dei dati in modo selettivo. Rendono utilizzabile l’informazione che esiste in forma aggregata o non strutturata e, quando i dati locali sono pochi, riducono l’incertezza in misura calcolabile; la verifica conferma il meccanismo, ma mostra che il risultato dipende dal contenuto informativo attribuito alla stima esterna più che dalla sua media. Per le perdite non dichiarate e per gli eventi estremi servono ipotesi dichiarate e analisi di sensibilità, e dove le code sono pesanti l’analisi deve poggiare su quantili e scenari. Nella pratica conviene dichiarare le stime a priori e il peso che si attribuisce loro, pesare meno le osservazioni più vecchie, tenere distinti i valori stimati da quelli osservati e verificare i modelli sui propri dati, ripetendo la verifica nel tempo. Resta da misurare se le stime ottenute con queste tecniche si avvicinino di più alle perdite poi registrate.
Come citare
Calabrò, V. (2026). Analisi quantitativa con pochi dati: il contributo dell’AI-driven Cyber Risk Management. White paper. https://www.vincenzocalabro.it/article/2026/analisi-quantitativa-pochi-dati-ai-driven-cyber-risk-management.html · PDF
Riferimenti principali
- FIRST, The EPSS Model.
- NIST (2026). NIST Updates NVD Operations to Address Record CVE Growth, 15 aprile 2026.
- CISA (2026). Known Exploited Vulnerabilities Catalog, versione 2026.11.20.
- The Open Group (2021). Open FAIR Body of Knowledge, standard O-RA 2.0.1 e O-RT 3.0.1.
- Cremer, F., et al. (2022). Cyber risk and cybersecurity: a systematic review of data availability, The Geneva Papers on Risk and Insurance, 47(3), 698-736.
- Woods, D. W., Böhme, R. (2021). SoK: Quantifying Cyber Risk, IEEE Symposium on Security and Privacy, 211-228.
- Direttiva (UE) 2022/2555, direttiva NIS2.
 Vincenzo Calabrò | Ingegnere informatico specializzato in sicurezza informatica e investigazioni digitali. Funzionario informatico del Ministero dell'Interno; su incarico autorizzato si occupa di sicurezza informatica e di perizie informatiche forensi. Autore di articoli e saggi. Lecturer, Speaker, Trainer.
Profili: Google Scholar · ORCID · ResearchGate · Academia.edu · Wikidata · CyberSecurity360 · AgendaDigitale · ICT Security Magazine · Amazon · LinkedIn · YouTube · Ordine degli Ingegneri di Reggio Calabria